Плеер для изучения китайского по видео: субтитры по словам, словарь под курсором и слова — сразу в колоду
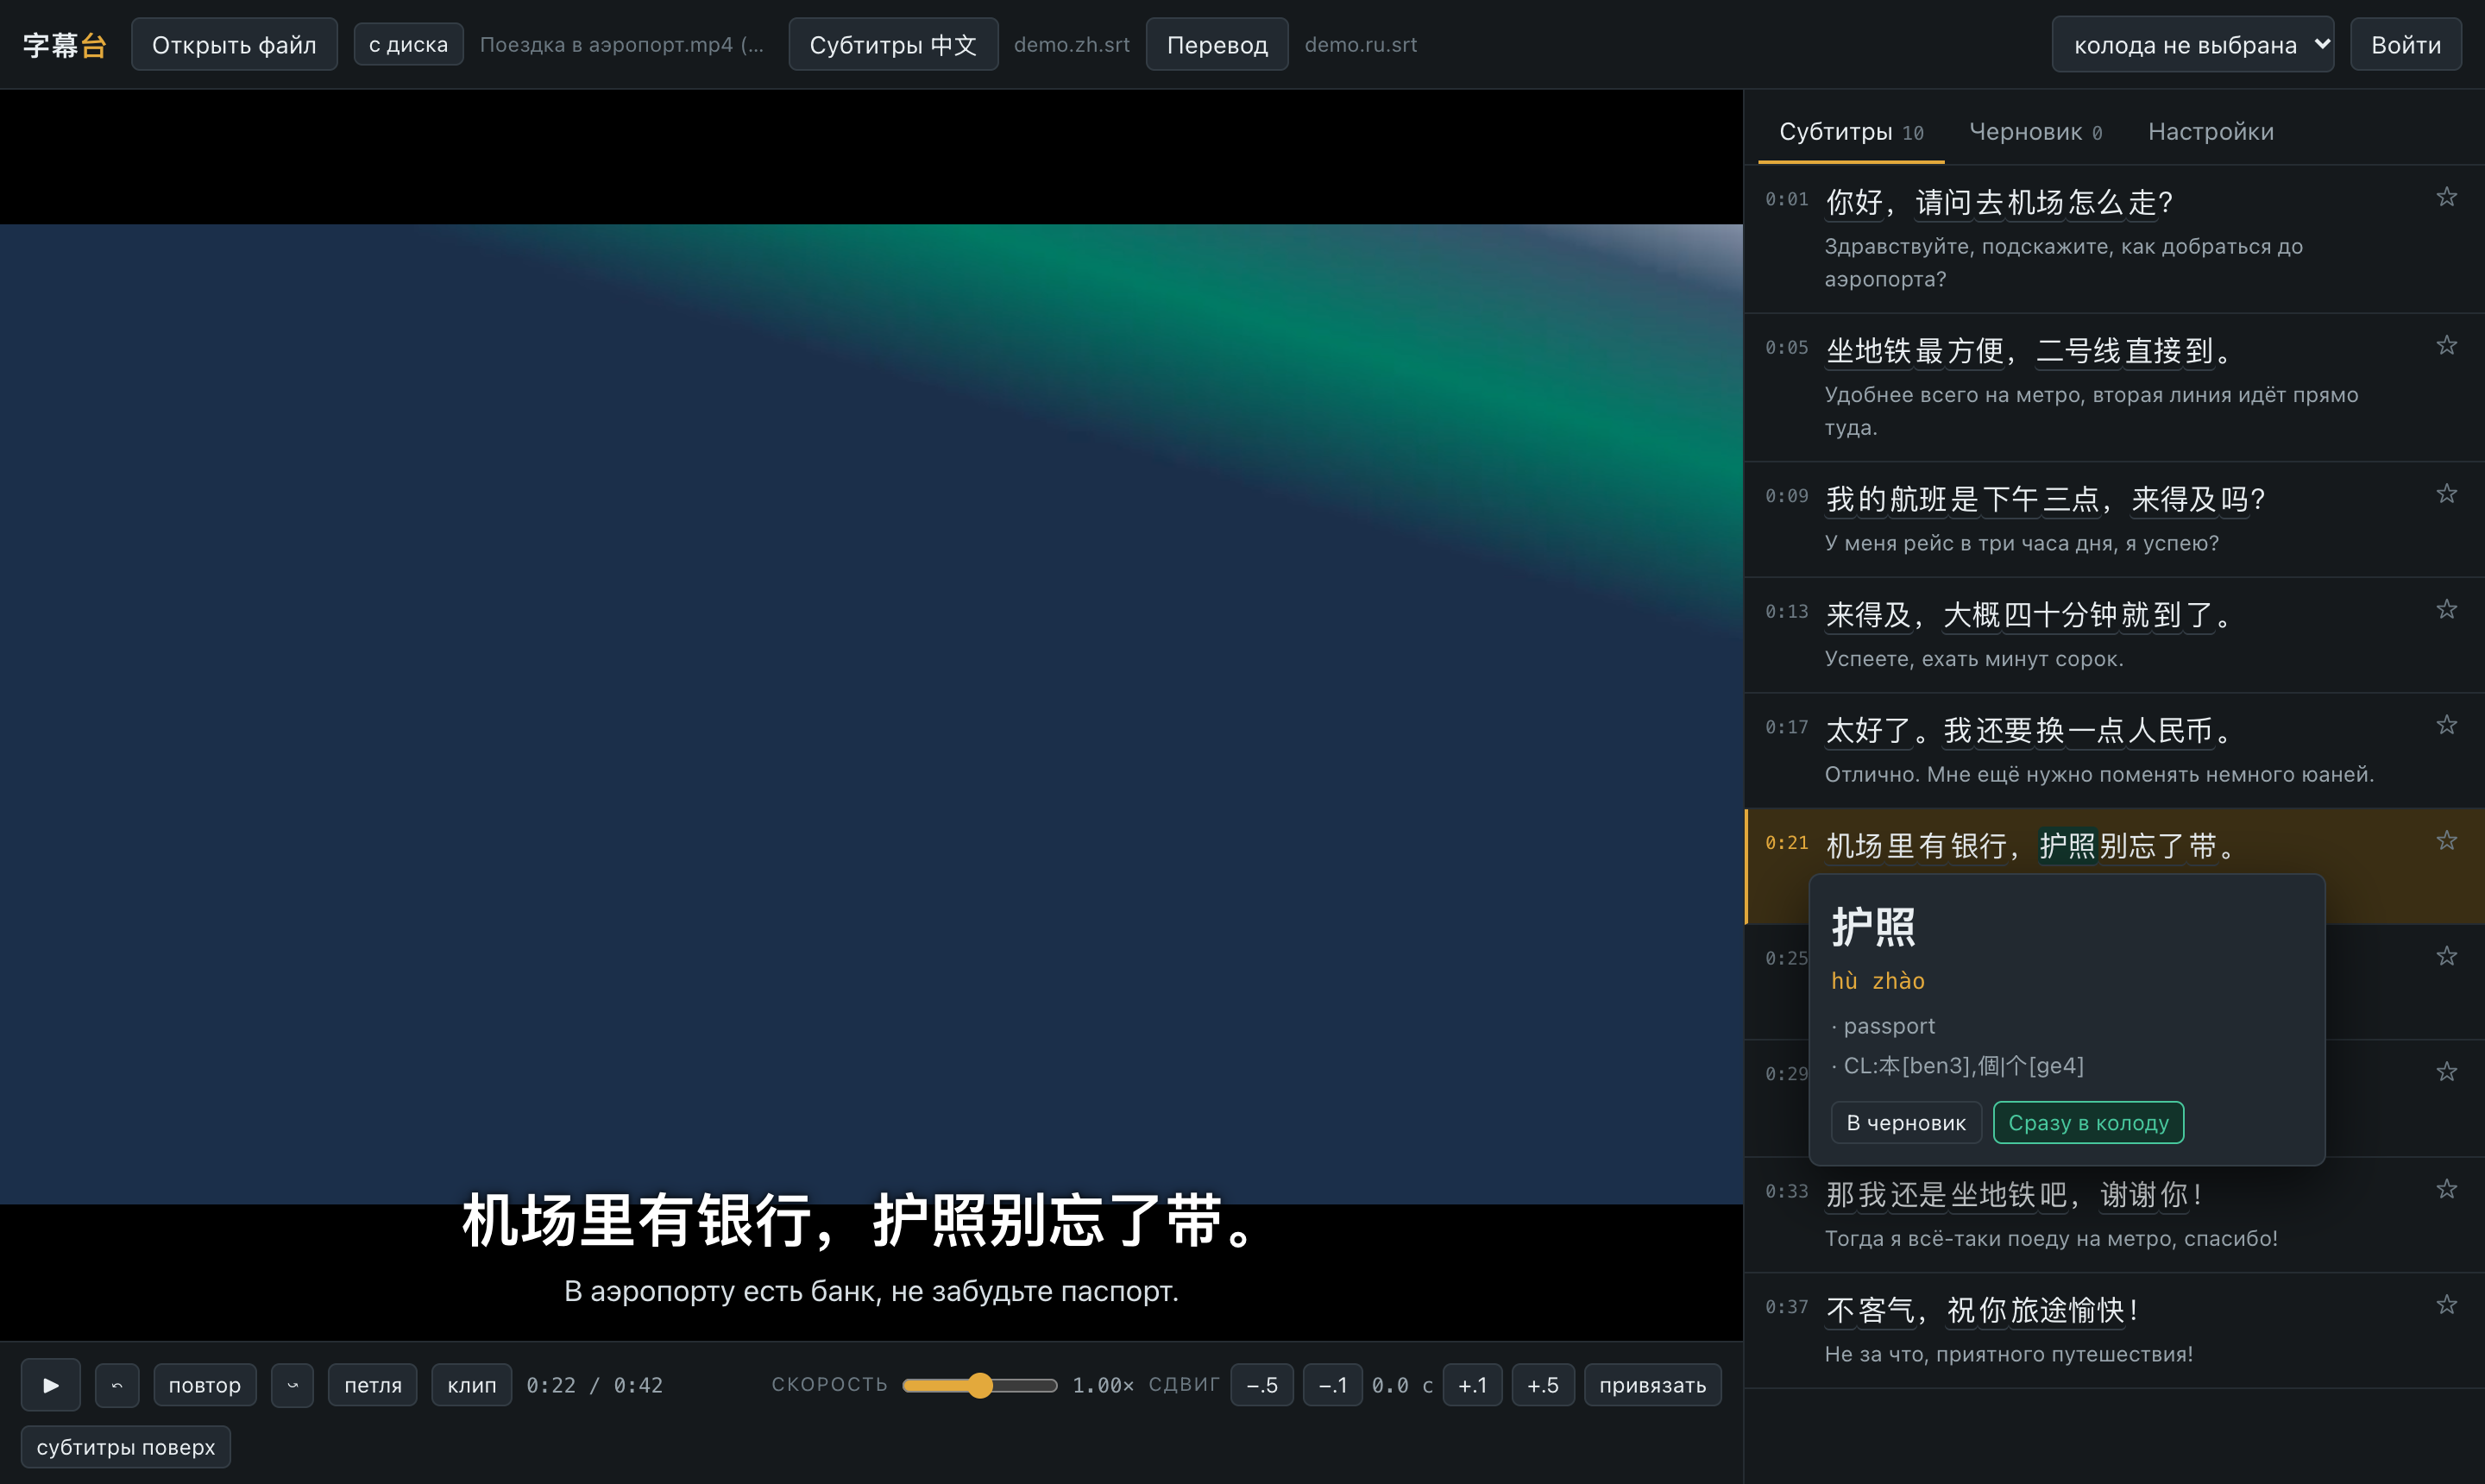
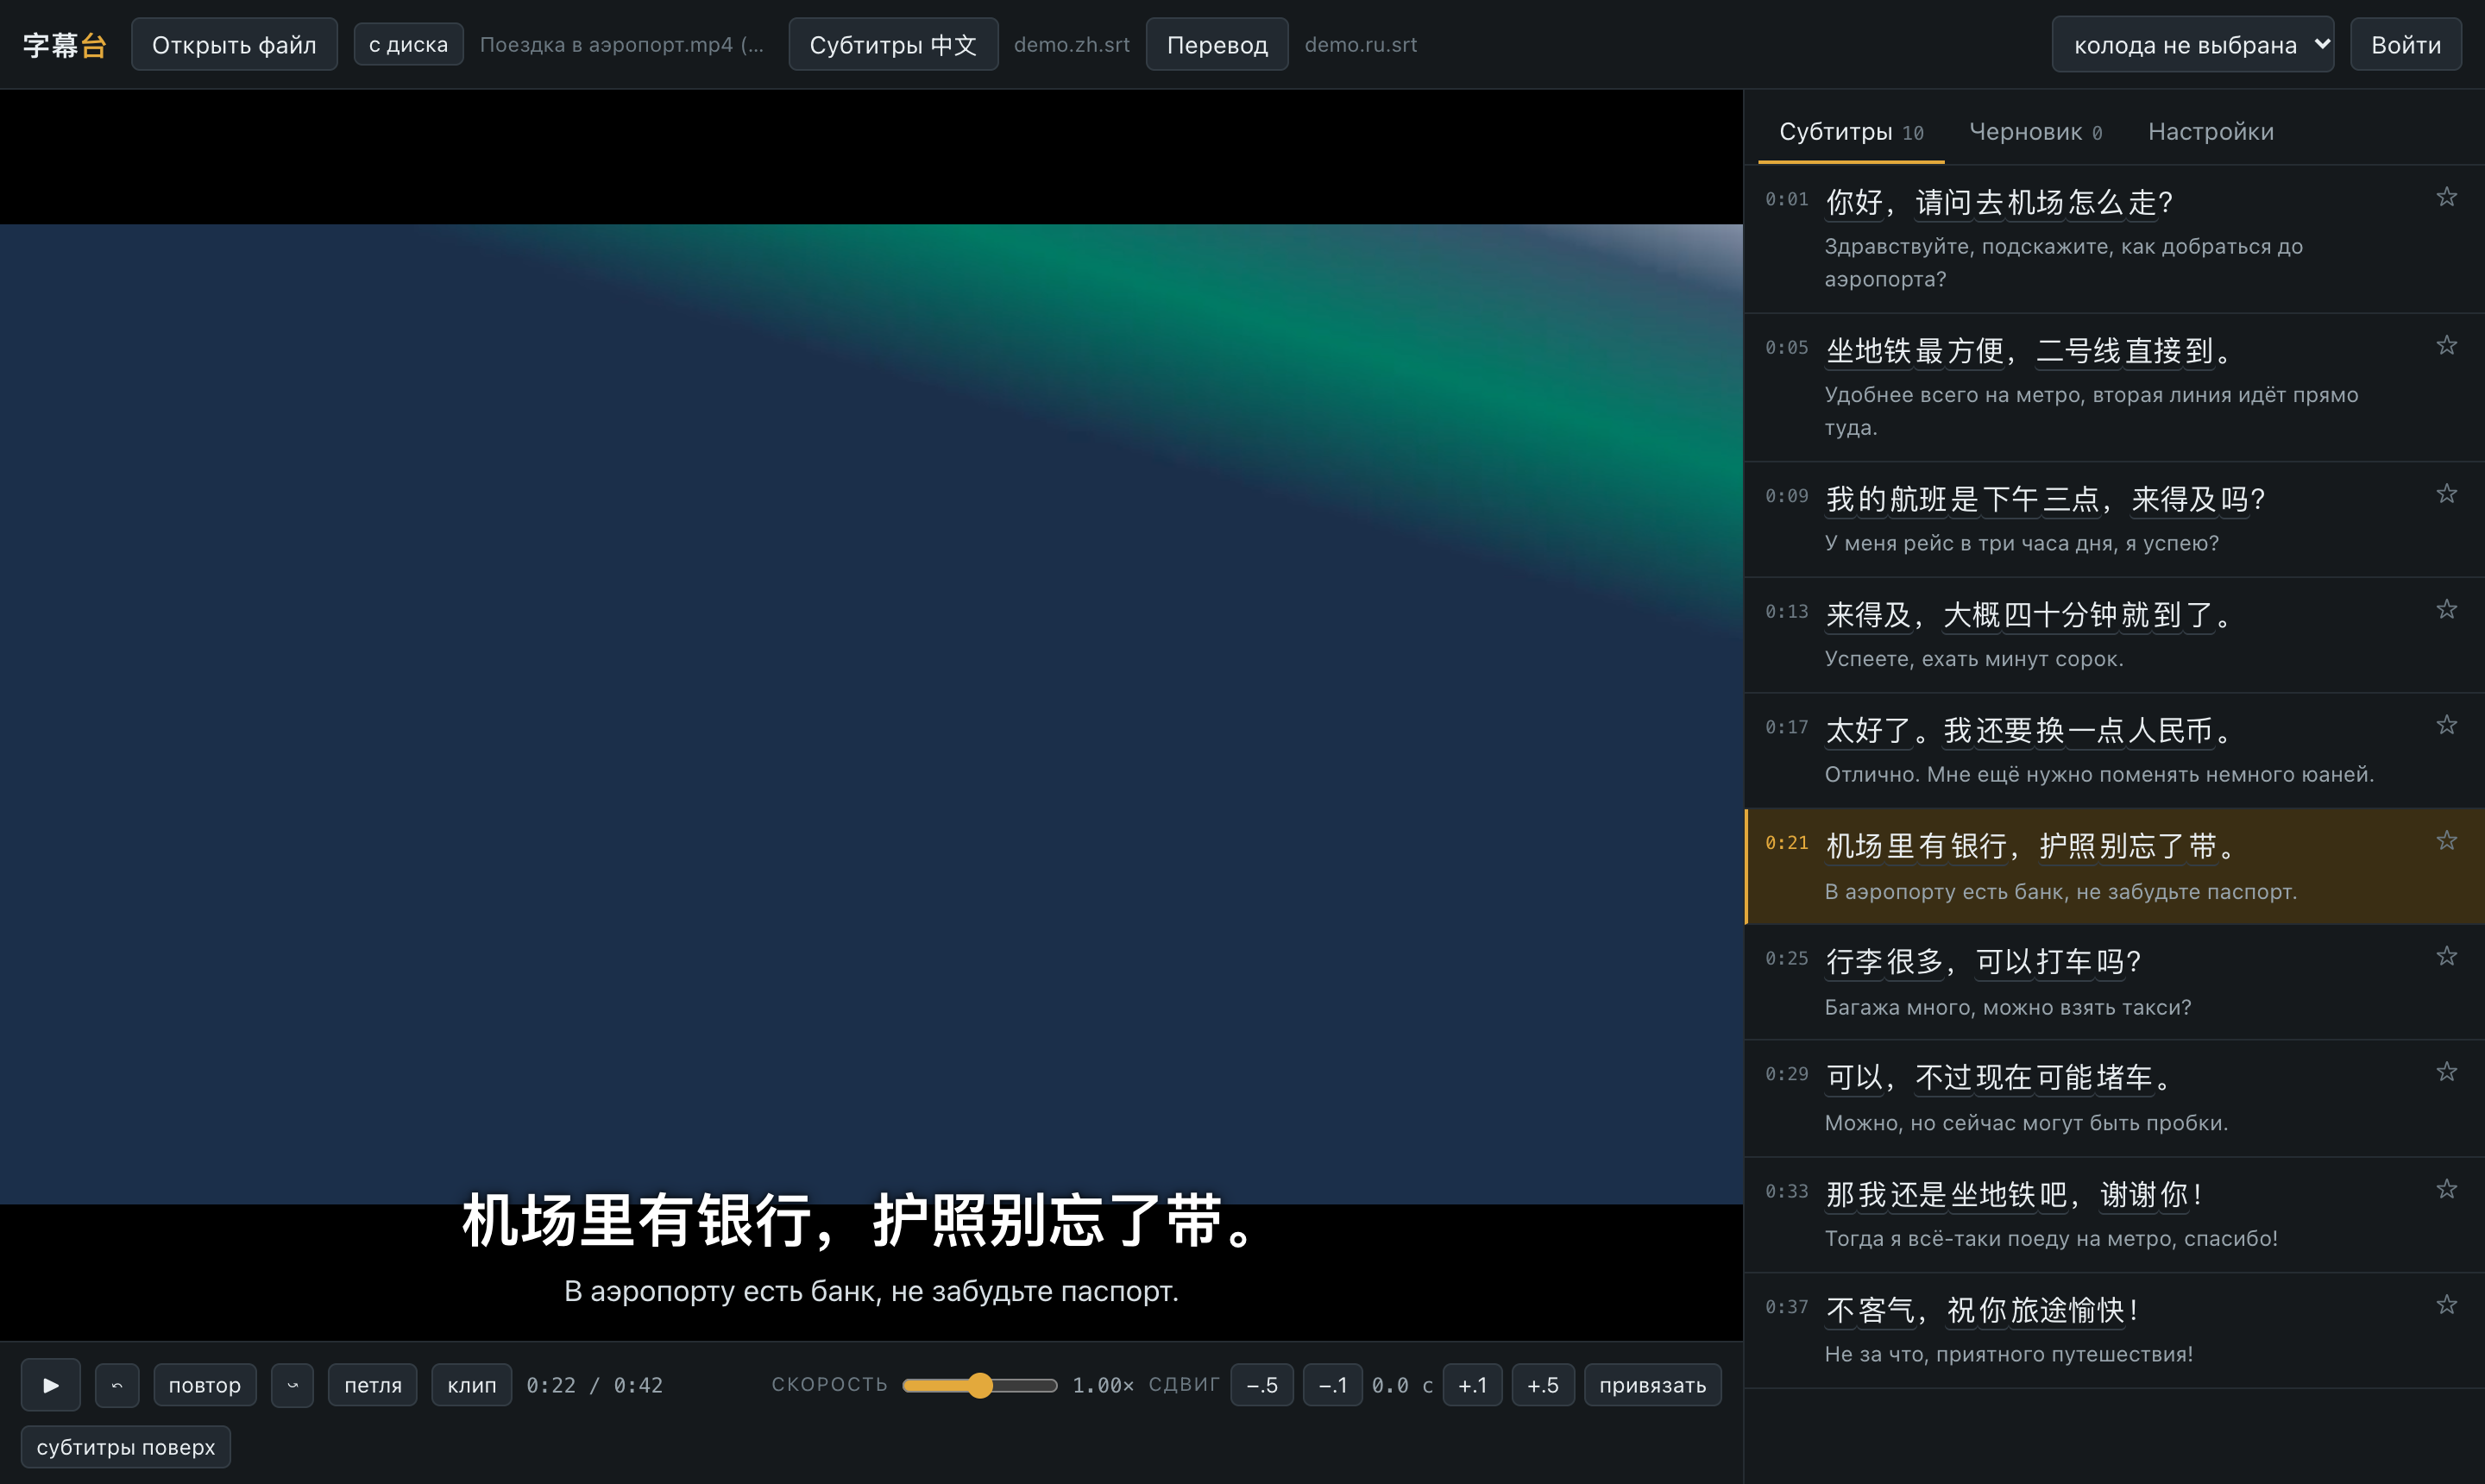
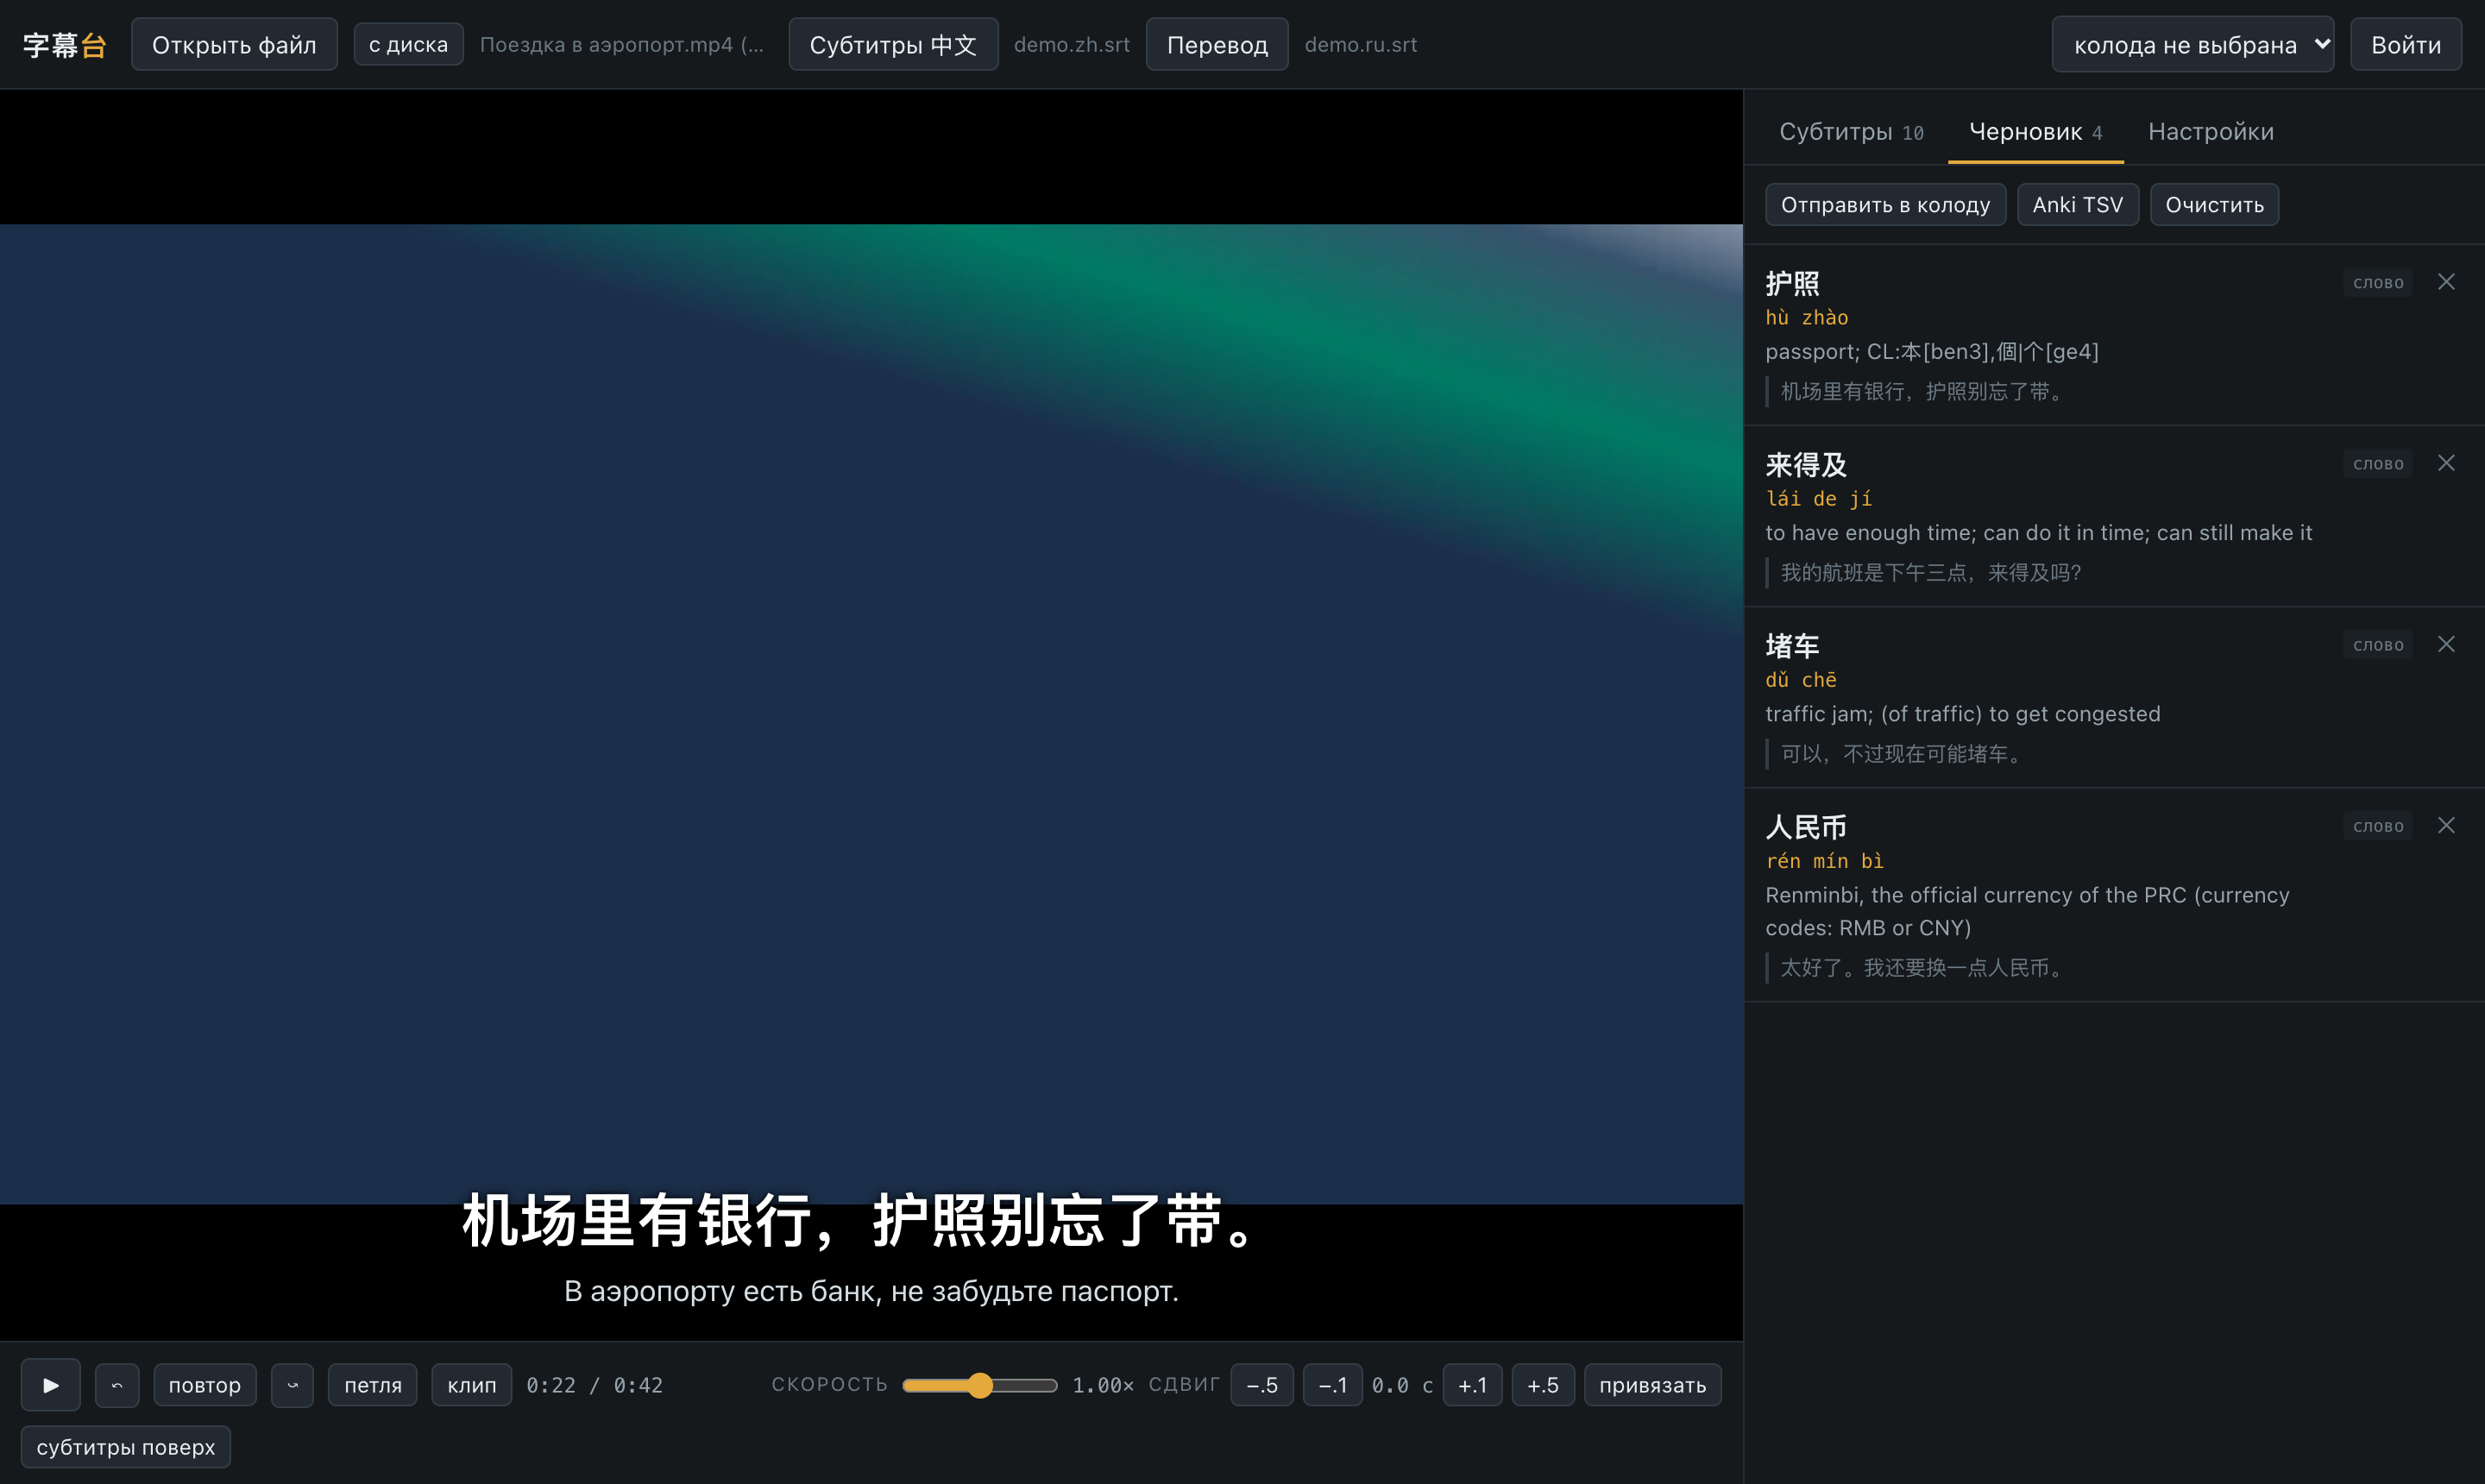
Открываешь серию и файл субтитров — каждая реплика разбита на слова. Клик по слову показывает чтение и значение, ещё один отправляет его в колоду на сайте 汉语中心 вместе с репликой, где оно встретилось. Всё работает локально: видео никуда не загружается.
Смотреть и учить, не отрываясь от серии
Разбивка на слова
В китайском нет пробелов. Реплики режет jieba, а слова из колод ученика подгружаются в её словарь — имена и термины из его материала режутся правильно.
Свои слова видно сразу
Слова из колод приглушены, новые — светлые, а те, на которых ученик ошибается, подсвечены жёлтым. Статистика приходит с сайта.
Слово вместе с контекстом
В колоду уходит не только слово, но и реплика, где оно прозвучало. Добавление идемпотентно: дубликатов не будет.
Повтор и петля
Повторить реплику, зациклить её, замедлить до 0,5×, сдвинуть субтитры на десятые доли секунды — всё с клавиатуры.
Клипы
Клавиша C вырезает реплику из видео через ffmpeg — готовый фрагмент для карточки.
Субтитры из звука
Если субтитров нет, их распознаёт Whisper, а отдельный скрипт чистит типичные повторы и галлюцинации поверх музыки и тишины.
Локальный сервер вместо одной страницы
Интерфейс открывается в браузере, но рядом работает маленький сервер на стандартной библиотеке Python. Он режет реплики, запускает ffmpeg и сам ходит на сайт.
- Приватность. Сервер слушает только 127.0.0.1. Наружу уходит лишь текст — слова и реплики, которые ученик сам отправил в колоду.
- Токен не в браузере. Он лежит в файле с правами 600; страница его не видит — запросы к сайту идут через локальный сервер.
- Работает без сети. Плеер, словарь и черновик не требуют входа на сайт.
- Продолжает с места. Позиция, субтитры и черновик запоминаются отдельно для каждого видео.
На чём сделано
Около 2,5 тысячи строк. Плеер — спутник сайта 汉语中心: колоды, прогресс и статистика ошибок живут там.